‘PostgreSQL’ タグのアーカイブ

murave

データベースコンテナでのバックアップの話(Docker)

先週、NISA(一般社団法人長崎県情報産業協会)の『Pythonと Docker ではじめる Web アプリ開発&運用入門』という研修に参加しました。

その中でコンテナ上のデータベースの論理バックアップの話があり、ホストPCにdumpツールを入れて普通にバックアップすればOKという流れだったのですが、自分はこの考え方で面倒な状況に陥ったことがありましたので

「稼働中のデータベースコンテナと同じイメージ上のdumpツールを別コンテナ起動してバックアップした方がバージョンミスマッチを回避できるので良いと思います」

というフィードバックをしました。

講師の方には伝わっていたと思いますが、痛い目の話、実際の例、あとちょっとしたハマりどころについて書いておこうと思います。

痛い目にあった話

今回の研修はMariadbでしたし、出力がSQLスクリプトのdumpをする場合はそもそもあまり問題ないと思います。
自分の場合はPostgreSQLを使うことが多く、pg_dumpのバージョンミスマッチでdumpできなくなるということを複数回経験しています。

今回のようにホストPCにツールを入れる場合ですが、コンテナとホストPCのOSが同じとは限らない(というか違うことが多い)わけで運用していくうちにコンテナで稼働しているデータベースのバージョンとホストPCのツールのバージョンを合わせるのが面倒な状況になることが結構あります。

他の例としては、昔、開発環境として Laradock (https://laradock.io/) を使っていたのですが、Laradock ではデータベースコンテナと作業用のコンテナが別になっています。作業用のコンテナにデータベースのクライアントツールを導入して扱うという形になるのですが、コンテナ間のバージョンを合わせるのが面倒で早々に破綻しました。

PostgreSQLでの実施例

そんなわけで、データベースコンテナ(のイメージ)には対応したバージョンのクライアントツールが入っているんだからそれを使うのがいいんじゃない?というわけです。

自分の場合、コンテナまわりの操作は docker compose、データベースはPostgreSQLのことが多いので、その組み合わせでの例とさせていただきます。

データベースコンテナのサービス名が postgres 、データベースがsampledb、データベースユーザーがsampleuser、パスワードがsamplepassとします。

docker compose exec -T postgres bash -c "PGPASSWORD=samplepass pg_dump -Fc --no-acl --no-owner -h postgres -U sampleuser sampledb" > sampledb.dump
PGPASSWORDをコマンドラインで書いちゃってるのはあまり良くないですね。

リストアも同じようにできると思いますが、自分はエラーメッセージなど確認したいので一旦コンテナにdumpファイルをコピーしてコンテナ上で実施しています。

# ホストPC上
$ docker compose cp sampledb.dump postgres:/tmp/
$ docker compose exec postgres bash

# コンテナ上
root@440414c73f7a:/# pg_restore -U sampleuser -d sampledb /tmp/sampledb.dump
root@440414c73f7a:/# rm /tmp/sampledb.dump
素のdockerとcomposeのexecの違いでハマる前述の exec でオプションに -T (–no-TTYでもOK)を指定しているのに注目してください。これは疑似 TTY 割り当てを無効化するものです。
TTY有効だとpg_dumpからバイナリで出力されたファイルが破損します。

ややこしいのがdocker compose execだとTTY有効がデフォルト、docker execだとTTY無効がデフォルトだということです。

同じ目にあった人がいたので解決は早かったですが、気づかんて。

Why is pg_restore segfaulting in Docker?
https://stackoverflow.com/questions/63934856/why-is-pg-restore-segfaulting-in-docker

リストア時にセグメンテーションフォールトを喰らって気づくという悲劇もありえます。リストアのテスト大事ですね。

murave

Laravel 5.5 でデータベースdumpをお手軽にとったりもどしたり

muraveです。LTSを使いたい人なのでLaravelのバージョンが5.1から5.5にジャンプアップしました。
その際、いままで使っていたデータベースバックアップのプラグインが使えなくなりました。

データベースdumpをお手軽にとったりもどしたりしたかっただけだったんだけど、重厚なバックアップ用パッケージが見つかった。これはこれで入れとくかぁ。
— murave (@murave) 2017年11月24日

ということで

https://github.com/spatie/laravel-backup

を導入。良い感じです。もしかして?と、この方のリポジトリを探してみたらありました。

https://github.com/spatie/laravel-db-snapshots

This package provides Artisan commands to quickly dump and load databases in a Laravel application.

そうそう、この記事の対象データベースはPostgreSQLです。

PostgreSQLの場合にレストア時にエラーでデータベースを飛ばしたので、その対処方法のメモだったりします。MySQL、SQLiteにも対応らしいですが試してません。導入や使い方はドキュメント見てくださいね。

ドキュメント通りにスナップショットをロード(restore)しようとしたらエラーでコケたのでした。

# artisan snapshot:load my-first-dump

[Illuminate\Database\QueryException]
SQLSTATE[42601]: Syntax error: 7 ERROR: syntax error at or near "\"
LINE 464: \.
^ (SQL: --

### 以下略

で、コケるとデータベース飛びます(掃除がリストアの前に別途行われるようです)。

バックアップ・リストアのテストしててバックアップオプションを変えてからデータのバックアップが取れないと思ってたら、リストアのテストの失敗でデータが消滅してたせいだった。
— murave (@murave) 2017年11月27日

こんあとき、ボクのように上書きで再度スナップショットを取ると空のデータベースのdumpで上書きという悲劇が起こるので気をつけましょう。

dumpファイルの内容を調べるとCOPY from stdinで.から読むようになってるところでコケてます。

「ははーん。pg_dump呼び出しに–insertsつければいいんだな」

pg_dumpに–insertsオプションをつけるとデータをCOPYではなくINSERTコマンドでdumpします。

「どうやってつけたらいいんだ?」

コードを追ったらdatabase.phpでdumpのオプション付けられるようになってました。
insertsオプションにも対応してます。サンプル載せときます。

'pgsql' => [
'driver' => 'pgsql',
'host' => env('DB_HOST', '127.0.0.1'),
'port' => env('DB_PORT', '5432'),
'database' => env('DB_DATABASE', 'forge'),
'username' => env('DB_USERNAME', 'forge'),
'password' => env('DB_PASSWORD', ''),
'charset' => 'utf8',
'prefix' => '',
'schema' => 'public',
'sslmode' => 'prefer',
//PDO絡みで環境によって型がばらつく可能性があるので割り切って全て文字列で取得。
'options' => [
PDO::ATTR_STRINGIFY_FETCHES => true,
],
'dump' => [
'useInserts',
],
],
‘dump’ => [‘useInserts’] の所です。無事snapshot:loadできるようになりました。

# artisan snapshot:create for-test-dump
# artisan --env=testing snapshot:load for-test-dump
これはデフォルトの環境でスナップショットを取ってtesting環境でロード(restore)してます。

PDO::ATTR_STRINGIFY_FETCHESについての余談

前記database.phpのサンプルのコメントにありますが、開発環境ではintで取れてたのに本番のサーバーにデプロイしたらstringで返ってくるなどデータ取得時に動作環境によって型がばらつくことがあります。

厳密比較の動作が異なって判定が変わったり、unit testがコケたりと困ったことになるので全て文字列で取得するオプションを設定するようにしています。

Model経由で値を扱う場合は

/**
* キャスト設定(文字列以外は要設定)
*
* @var array
*/
protected $casts = [
'id' => 'integer',
'updated_by' => 'integer',
'options' => 'array', //jsonb
];
のように$castsに書いておけばLaravelさんがキャストしてくれます。

murave

Docker公式イメージで開発用RDBをゲットだぜ(PostgreSQL編)

まえがき

Laravelでの開発時にデプロイ先はMySQLなのに手を抜いて手元の開発機ではSQLiteを使っていたら痛い目にあったりしました、muraveです。

SQLiteって結構ルーズにつかえてしまうので手元の開発でSQLite使っててMySQL運用のサーバーにデプロイするとエラーがバンバンというのが昨日から連続発生中。
— murave (@murave) 2016年7月14日

開発環境にあまり影響を与えずにサクッと開発用のRDB(Relational Database)を建てられると素敵ですね。Docker公式イメージを活用すると出来そうです。

RDBというデッカイ単語を使っていますが、自分がよく使うPostgreSQL、MySQL、MariaDBなどについて調べようと思います。MySQLとMariaDB自体はほぼ同じ扱い方ができるRDBですが、公式イメージでの扱いはどうなんでしょうね。

記事にまとめながら試していこうと思います。Docker for Macを使用しており、今回はPostgreSQLです。

PostgreSQL

公式イメージを調べる

OFFICIAL REPOSITORY postgres

2016年8月中旬現在、以下のバージョンがあるようです。

9.6(9.6-beta4) , 9.5(9.5.4), 9.4(9.4.9), 9.3(9.3.14), 9.2(9.2.18), 9.1(9.1.23)

流石に8系はないですね。使いたくないですよね。忘れましょう。客先には残ってますが。

起動する

試していきます。せっかくですから9.6でやってみようと思います。

$ docker run -d --name postgres96beta4 -e POSTGRES_PASSWORD=mysecretpassword -p 15432:5432 postgres:9.6
公式の例を参考にコンテナの5432を15432にポートフォワードなど追加しておきました。

接続する

psqlでの接続ですが、公式には別コンテナを立ち上げての接続例が載ってますね。

$ docker run -it --rm --link postgres96beta4:postgres postgres:9.6 psql -h postgres -U postgres
Password for user postgres:
psql (9.6beta4)
Type "help" for help.

postgres=# select version();
version
---------------------------------------------------------------------------------------------
PostgreSQL 9.6beta4 on x86_64-pc-linux-gnu, compiled by gcc (Debian 4.9.2-10) 4.9.2, 64-bit
(1 row)

postgres=# \l
List of databases
Name | Owner | Encoding | Collate | Ctype | Access privileges
-----------+----------+----------+------------+------------+-----------------------
postgres | postgres | UTF8 | en_US.utf8 | en_US.utf8 |
template0 | postgres | UTF8 | en_US.utf8 | en_US.utf8 | =c/postgres +
| | | | | postgres=CTc/postgres
template1 | postgres | UTF8 | en_US.utf8 | en_US.utf8 | =c/postgres +
| | | | | postgres=CTc/postgres
(3 rows)

postgres=# \q
–rm を付けてあるので抜けるとコンテナは消えます。儚い。

ポートフォワードしてあるのでMacからつなぐこともできますが、当然、psqlのバージョンはMac上のものになります。

$ psql -h localhost -p 15432 -U postgres
Password for user postgres:
psql (9.3.5, server 9.6beta4)
WARNING: psql major version 9.3, server major version 9.6.
Some psql features might not work.
Type "help" for help.

postgres=# \q
9.3用なので警告がでています。

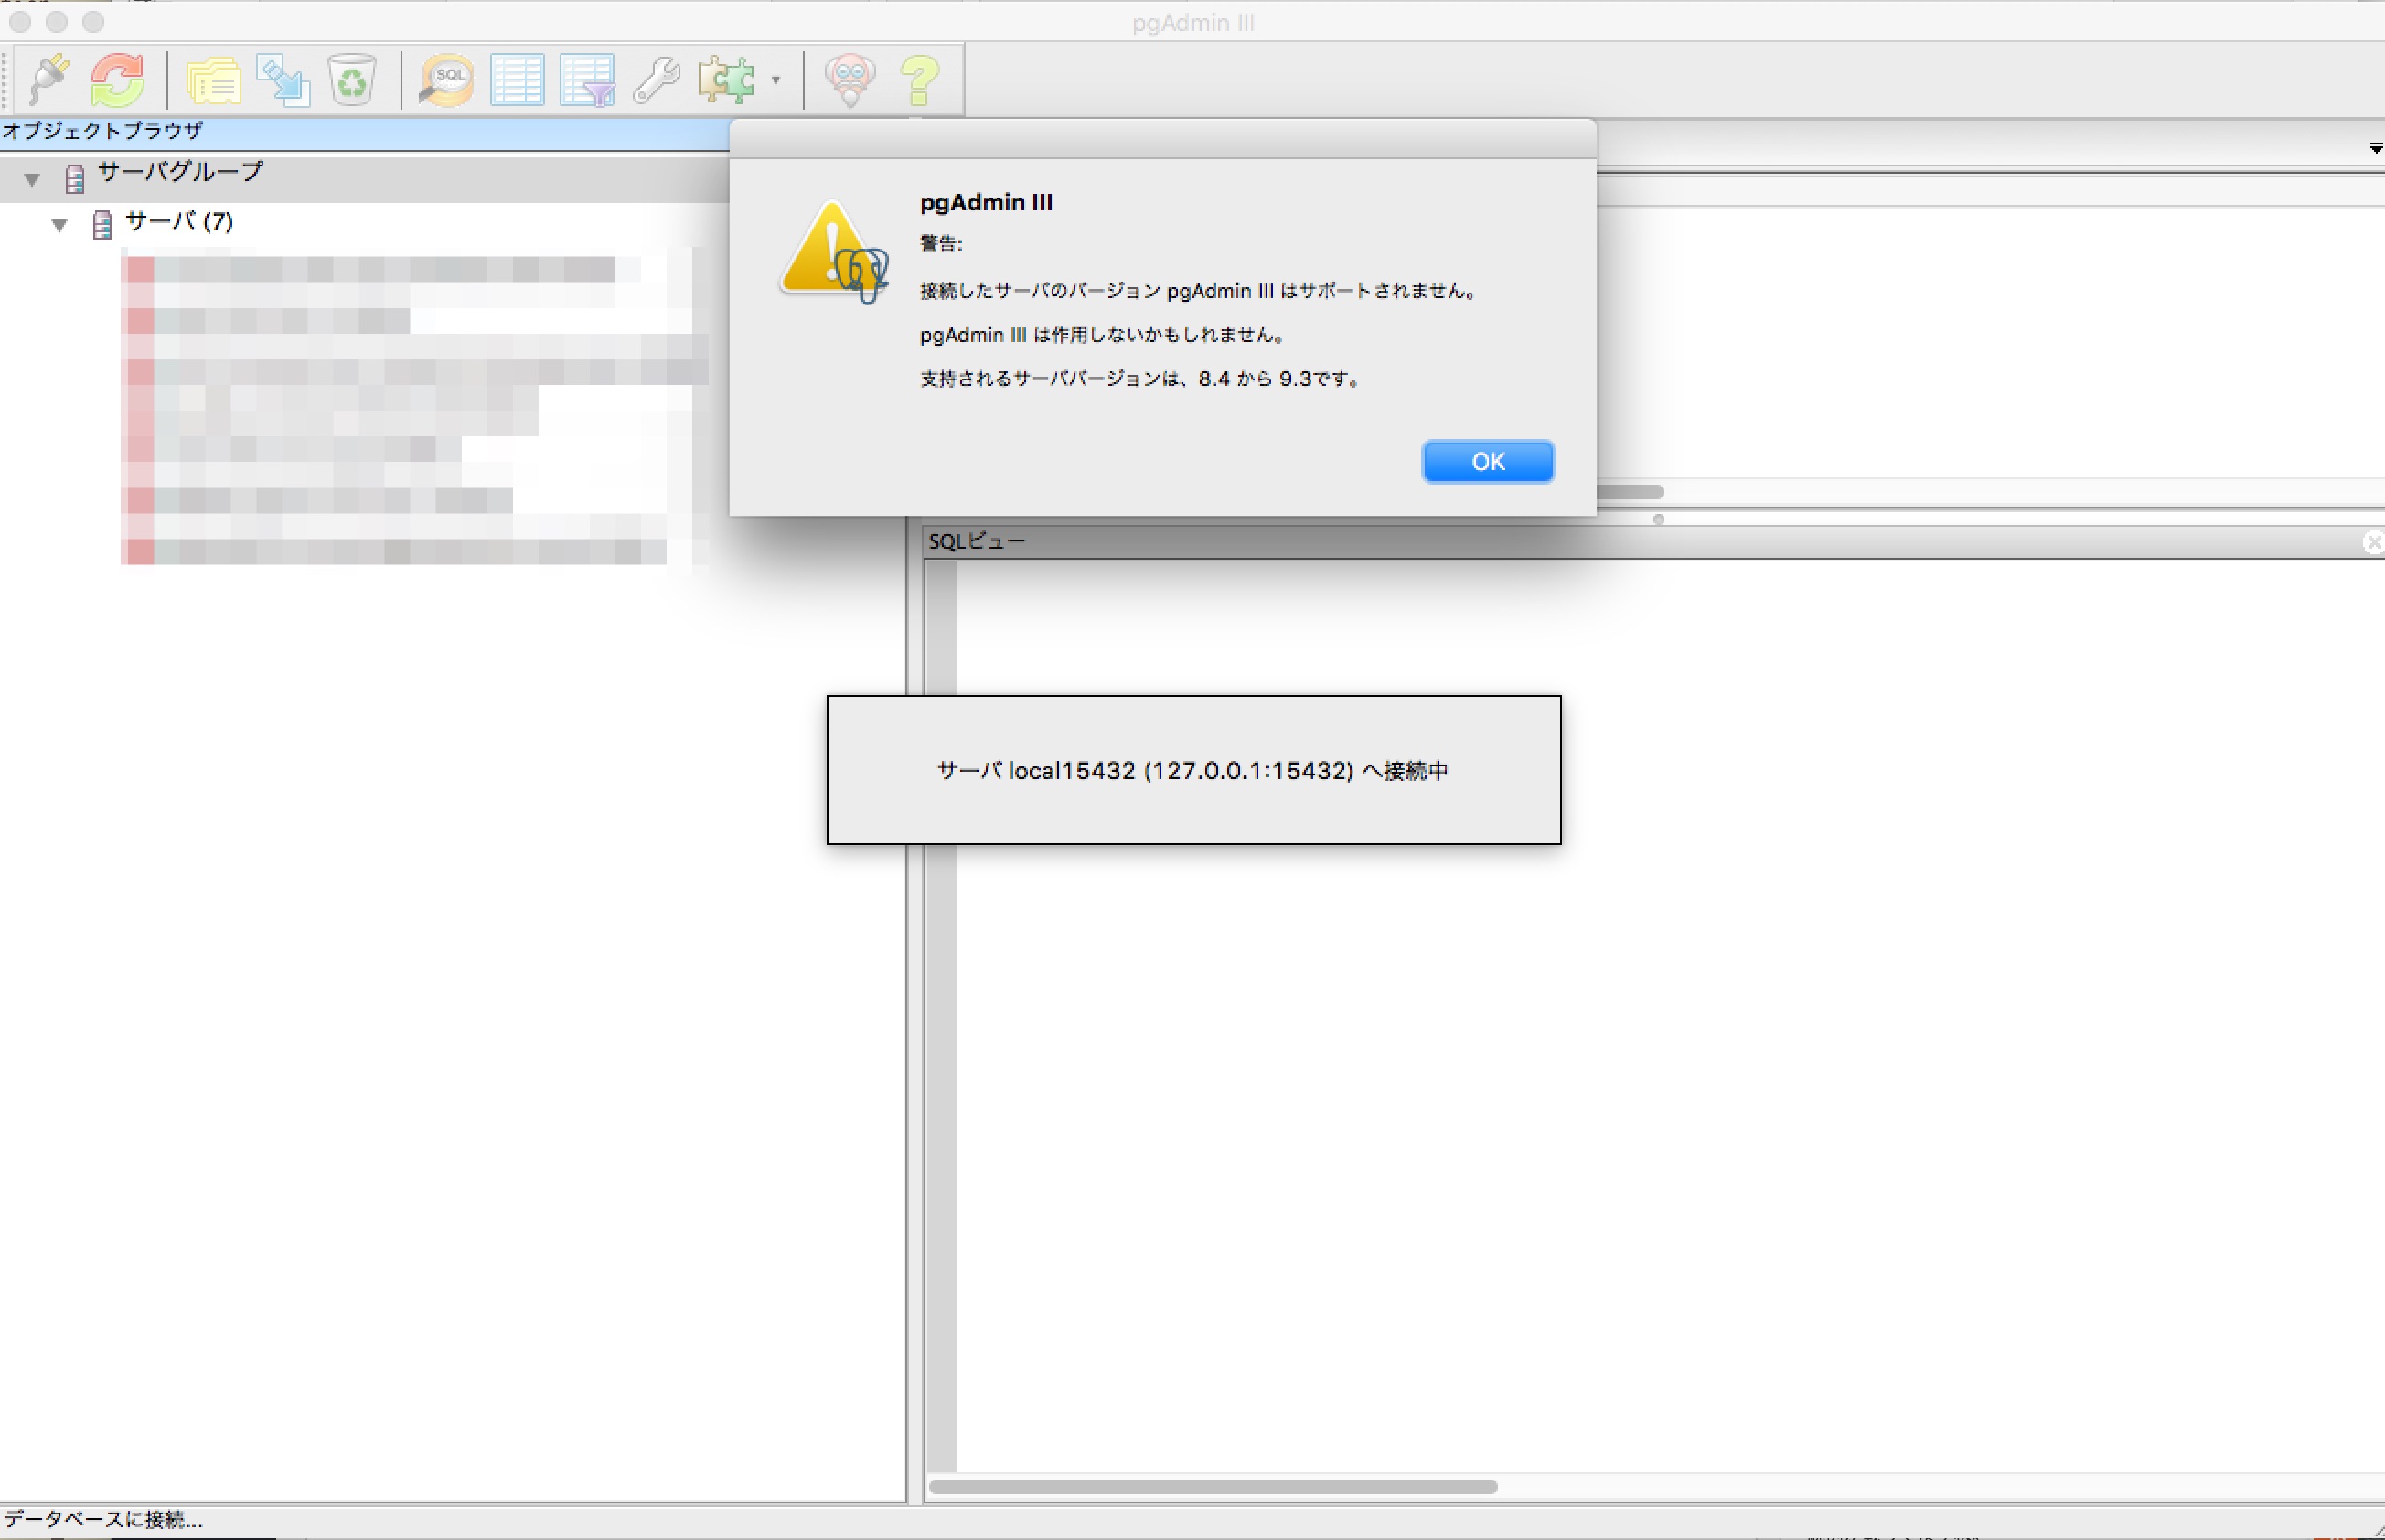
愛しのpgAdmin3でつないでみましょう。pgAdmin3も9.3用なので警告されております。

pgAdmin3でDockerコンテナ上のPostgreSQLに接続(バージョン警告)

接続はできました。

pgAdmin3でDockerコンテナ上のPostgreSQLに接続して操作

ほぼ使えましたがPostgreSQL9.6に対してツールのバージョンが9.3用と古いのでエラーがでたりもしますね。
psqlのみで作業するのはツライのでツールは対象に合わせたバージョンを用意しないとあかんなぁと思いました。

設定ファイルなど

コンテナのシェルを起動して探検。

$ docker exec -it postgres96beta4 bash
root@d2e991bd61a7:/# cd /var/lib/postgresql/data/
root@d2e991bd61a7:/var/lib/postgresql/data# more postgresql.conf
と、このようにpostgresql.confを眺めてみたり(lessもviもなかった)。

root@d2e991bd61a7:/var/lib/postgresql/data# more pg_hba.conf
pg_hba.confを眺めてみたり。pg_hba.confから抜粋しますと

# TYPE DATABASE USER ADDRESS METHOD
# "local" is for Unix domain socket connections only
local all all trust
# IPv4 local connections:
host all all 127.0.0.1/32 trust
# IPv6 local connections:
host all all ::1/128 trust

host all all 0.0.0.0/0 md5
ローカルからはtrustで他はパスワード認証ですかね。

拡張する

コンテナの /docker-entrypoint-initdb.d に拡張子がsql、shのファイルを置くとコンテナ起動時に実行してくれるそうです。
他、Dockerfileでdefault localeを設定するという例が公式のページに例として載っています。

やってみましょう。

日本語化されたイメージの作成

default localeを設定するDockerfileを作ります。

Dockerfile

FROM postgres:9.6

MAINTAINER murave

RUN localedef -i ja_JP -c -f UTF-8 -A /usr/share/locale/locale.alias ja_JP.UTF-8
ENV LANG ja_JP.utf8
日本語化されたイメージ、mypostgres:9.6を作ります。

$ docker build -t mypostgres:9.6 ./
確認

$ docker images
REPOSITORY TAG IMAGE ID CREATED SIZE
mypostgres 9.6 4b7ea9f892dd 24 seconds ago 269.2 MB
データベースの初期化操作しているディレクトリに/docker-entrypoint-initdb.d対応用にinitdbというディレクトリを作成しました。postgres/9.6/docker-entrypoint.sh を読んでみたところ

for f in /docker-entrypoint-initdb.d/*; do
case "$f" in
*.sh) echo "$0: running $f"; . "$f" ;;
*.sql) echo "$0: running $f"; "${psql[@]}" < "$f"; echo ;;
*.sql.gz) echo "$0: running $f"; gunzip -c "$f" | "${psql[@]}"; echo ;;
*) echo "$0: ignoring $f" ;;
esac
echo
done
で順次処理となっているのでファイル名順に実行されるようです。sqlをgzip圧縮したsql.gz拡張子のファイルにも対応しているようですね。

初期化時にdockerユーザーとdockerテーブルを作成するshを作成します。

initdb/01adduser.sh

#!/bin/bash
set -e

psql -v ON_ERROR_STOP=1 --username "$POSTGRES_USER" <<-EOSQL
CREATE USER docker;
ALTER USER docker WITH PASSWORD 'dockerpassword';
CREATE DATABASE docker;
GRANT ALL PRIVILEGES ON DATABASE docker TO docker;
EOSQL
次にsqlファイル内で\cでデータベースとユーザーをdockerに切り替えてテーブルを作ってみます。shでdb接続からしたほうが簡単な気がしますが、実験です。

initdb/02createtb.sql

\c docker docker

CREATE TABLE auth_group (
id integer NOT NULL,
name character varying(80) NOT NULL
);

COPY auth_group (id, name) FROM stdin;
1 Gyoumu
2 Master
3 System
\.
日本語化したmypostgres:9.6からMacのinitdbディレクトリを/docker-entrypoint-initdb.dにバインドしてコンテナを起動します。

$ docker run -d --name postgres96beta4 -e POSTGRES_PASSWORD=mysecretpassword -p 15432:5432 -v $(pwd)/initdb:/docker-entrypoint-initdb.d mypostgres:9.6
psqlで繋いで確認してみます(一応mypostgres:9.6イメージの方のものを使用)。

$ docker run -it --rm --link postgres96beta4:postgres mypostgres:9.6 psql -h postgres -U postgres
ユーザ postgres のパスワード:
psql (9.6beta4)
"help" でヘルプを表示します.

postgres=# \l
docker | postgres | UTF8 | ja_JP.utf8 | ja_JP.utf8 | =Tc/postgres +
| | | | | postgres=CTc/postgres+
| | | | | docker=CTc/postgres
postgres | postgres | UTF8 | ja_JP.utf8 | ja_JP.utf8 |
template0 | postgres | UTF8 | ja_JP.utf8 | ja_JP.utf8 | =c/postgres +
| | | | | postgres=CTc/postgres
template1 | postgres | UTF8 | ja_JP.utf8 | ja_JP.utf8 | =c/postgres +
| | | | | postgres=CTc/postgres

postgres=# \c docker docker
ユーザ docker のパスワード:
データベース "docker" にユーザ"docker"として接続しました。
docker=> \dt
public | auth_group | テーブル | docker

docker=> select * from auth_group;
1 | Gyoumu
2 | Master
3 | System

docker=> \q
日本語化されたイメージを元に、01adduser.shでdockerユーザーを作成してパスワードを設定、dockerデータベースを作り、02createtb.sqlでdockerデータベースdockerユーザーに切り替えてauth_groupテーブルを作成し、データを流し込めていることが確認できました。

Docker Compose で開発用の PostgreSQL を起動する

日本語化したイメージを使用し、initdbのスクリプトで初期化、データの永続化はbusyboxを使用する方針でdocker-compose.ymlを作成します。

docker-composeでmysql & postgreSQL をサクッと起動

を参考にさせていただきました。

docker-compose.yml

postgres-data:
image: busybox
volumes:
- /var/lib/postgresql/data
container_name: postgres-datastore

postgresql:
image: mypostgres:9.6
environment:
POSTGRES_USER: postgres
POSTGRES_PASSWORD: mysecretpassword
volumes:
- ./initdb/:/docker-entrypoint-initdb.d
ports:
- "15432:5432"
container_name: postgres-db
volumes_from:
- postgres-data
起動します。

$ docker-compose up -d
Creating postgres-datastore
Creating postgres-db
以降、使用するあいだはstop・startで停止・起動していく感じでしょうか。

psqlやpgAdmin3で動作確認。OKでしたのでこれからはコレをベースに調整すれば簡単にPostgreSQLを準備できます。

ディレクトリファイル構成は以下のようになりました。

.
├── Dockerfile
├── docker-compose.yml
└── initdb
    ├── 01adduser.sh
    └── 02createtb.sql
murave

お気楽スロークエリ(JOIN & GROUP編)

運用中の業務系システムがあるんですが、お客様から「遅い」とご指摘を頂いた機能を調べたところ台帳からデータを取得し、集計しているクエリが非常に遅い事が判明しました。

調査している環境のデータベースは PostgreSQL 9.3 です。こんな時は EXPLAIN ANALYZE。

ちなみにhaisou_daityouが台帳で現在2850万件程のデータがあり日々増え続けています。
syouhin_detailはマスタで380件程度です。

EXPLAIN ANALYZE

SELECT
haisou_daityou.syouhin_detail_id,
syouhin_detail.code as syouhin_detail_code,
haisou_daityou.haisou_bi,
date_part('day'::text, haisou_daityou.haisou_bi)::int as day,
sum(haisou_daityou.haisou_suu) AS haisou_sum

FROM haisou_daityou
LEFT OUTER JOIN syouhin_detail ON haisou_daityou.syouhin_detail_id = syouhin_detail.id

WHERE
"YearMonth"(haisou_daityou.haisou_bi) = "YearMonth"('2016-03-01'::date)

GROUP BY
haisou_daityou.syouhin_detail_id,
syouhin_detail.code,
haisou_daityou.haisou_bi

ORDER BY
syouhin_detail.code,
haisou_daityou.haisou_bi

結果

GroupAggregate (cost=1141834.38..1173281.22 rows=1048228 width=18) (actual time=30736.728..35349.575 rows=9393 loops=1)
-> Sort (cost=1141834.38..1144454.95 rows=1048228 width=18) (actual time=30735.447..34864.067 rows=1024085 loops=1)
Sort Key: syouhin_detail.code, haisou_daityou.haisou_bi, haisou_daityou.syouhin_detail_id
Sort Method: external merge Disk: 30048kB
-> Hash Left Join (cost=650914.54..994020.09 rows=1048228 width=18) (actual time=1812.137..5063.999 rows=1024085 loops=1)
Hash Cond: (haisou_daityou.syouhin_detail_id = syouhin_detail.id)
-> Bitmap Heap Scan on haisou_daityou (cost=650901.04..979593.45 rows=1048228 width=12) (actual time=1811.261..4238.580 rows=1024085 loops=1)
Recheck Cond: ((((date_part('year'::text, (haisou_bi)::timestamp without time zone))::integer * 100) + (date_part('month'::text, (haisou_bi)::timestamp without time zone))::integer) = 201603)
Rows Removed by Index Recheck: 191609
-> Bitmap Index Scan on haisou_daityou_tokuisaki_yearmonth_updated (cost=0.00..650638.98 rows=1048228 width=0) (actual time=1808.060..1808.060 rows=1024085 loops=1)
Index Cond: ((((date_part('year'::text, (haisou_bi)::timestamp without time zone))::integer * 100) + (date_part('month'::text, (haisou_bi)::timestamp without time zone))::integer) = 201603)
-> Hash (cost=8.78..8.78 rows=378 width=10) (actual time=0.847..0.847 rows=379 loops=1)
Buckets: 1024 Batches: 1 Memory Usage: 17kB
-> Seq Scan on syouhin_detail (cost=0.00..8.78 rows=378 width=10) (actual time=0.007..0.697 rows=379 loops=1)
Total runtime: 35426.470 ms

うわぁ。おーそーいー。開発環境なので本番と比べると非常に非力ではありますが…

特に

「Hash LEFT JOIN (cost=650914.54..994020.09 ROWS=1048228 width=18) (actual TIME=1812.137..5063.999 ROWS=1024085 loops=1)」

お客さんからの「初回が特に遅い」という話にも納得(初回はハッシュテーブルが作られますが以降はキャッシュされますので)。

ちなみに前記の結果は初回ではありません。やばい。

INDEXを追加してみたり、集計されている中間テーブルを使っての再実装を検討したり(実際にクエリを書いてみたり)、WINDOW関数での再実装を検討したりしましたが、結局、次のような書き換えとなりました。

EXPLAIN ANALYZE

SELECT syouhin_detail.code as syouhin_detail_code, sum_tmp.*
FROM
(
SELECT
haisou_daityou.syouhin_detail_id,
haisou_daityou.haisou_bi,
date_part('day'::text, haisou_daityou.haisou_bi)::int as day,
sum(haisou_daityou.haisou_suu) AS haisou_sum

FROM haisou_daityou

WHERE
haisou_daityou.haisou_bi BETWEEN '2016-03-01'::date AND '2016-03-31'::date

GROUP BY
haisou_daityou.syouhin_detail_id,
haisou_daityou.haisou_bi
) as sum_tmp

LEFT OUTER JOIN syouhin_detail ON sum_tmp.syouhin_detail_id = syouhin_detail.id

ORDER BY
syouhin_detail.code,
sum_tmp.haisou_bi

結果

Sort (cost=87961.52..87988.41 rows=10756 width=26) (actual time=1640.387..1641.442 rows=9393 loops=1)
Sort Key: syouhin_detail.code, haisou_daityou.haisou_bi
Sort Method: quicksort Memory: 971kB
-> Hash Left Join (cost=86797.56..87241.25 rows=10756 width=26) (actual time=1516.623..1529.725 rows=9393 loops=1)
Hash Cond: (haisou_daityou.syouhin_detail_id = syouhin_detail.id)
-> HashAggregate (cost=86784.06..86972.29 rows=10756 width=12) (actual time=1516.362..1524.763 rows=9393 loops=1)
-> Index Scan using haisou_daityou_haisou_bi on haisou_daityou (cost=0.44..78691.12 rows=1079058 width=12) (actual time=0.028..758.021 rows=1024085 loops=1)
Index Cond: ((haisou_bi >= '2016-03-01'::date) AND (haisou_bi <= '2016-03-31'::date))
-> Hash (cost=8.78..8.78 rows=378 width=10) (actual time=0.245..0.245 rows=379 loops=1)
Buckets: 1024 Batches: 1 Memory Usage: 17kB
-> Seq Scan on syouhin_detail (cost=0.00..8.78 rows=378 width=10) (actual time=0.005..0.135 rows=379 loops=1)
Total runtime: 1642.233 ms

集計した後にJOINすることで20倍くらい速くなりました。初回ではもっともっと差がでるものと思われます。

集計のためにお気楽にJOINした後にGROUP BYしたのが悪かった模様。

お気楽に書いたクエリがスロークエリ化して泣いたお話でした。「JOIN & GROUP編」とはしたが続編はない!(といいな)

mine

OpenCOBOLとファイル操作(弊社拡張)

OpenCOBOLからのファイル操作ですが内部での定義によって幾つか種類があります。

  1. 固定長レコードのシーケンシャルファイル
  2. 固定長レコードのISAM形式ファイル
  3. 可変長レコードのシーケンシャルファイル
  4. 他

これらはCOBOLソース内でのSELECT句での定義でファイル名を直接または環境変数を経由して間接的に指定することが可能です。OpenCOBOLの素の状態ですと

SELECT ADBF0320 ASSIGN TO "FILE0001"
ORGANIZATION SEQUENTIAL
ACCESS MODE SEQUENTIAL.
と記述されている場合は、FILE0001または環境変数 DD_FILE0001または dd_FILE0001に設定されているファイル名のファイルのOPENが可能です。弊社ではこの環境変数渡しの機能を活用してperlからOpenCOBOL側へJCL中で使用しているファイル名を渡しています。
さて、JCL中ではSYSINと呼ばれる形式でファイルを作らずにその場で渡したいデータを記述することがあります。

\INPUT ACCEPT1,TYPE=DATASSF,LIST=YES
4241122 登録データ1
4241122 登録データ1追加分
\ENDINPUT;

ADAM2200:
\STEP PROG2000 FILE=USL.CAT1 DUMP=DATA SUBLM=NORMAL;
\ASSIGN FILE0010 USR.F001 SHARE=ALL HOLDMODE=NO;
\ASSIGN FILE0110 USR.F011-T FILESTAT=TEMP PUBLIC NORMAL=PASS;
\ALLOCATE FILE0110 USR.F011-T SIZE=05;
\DEFINE FILE0110 RECSIZE=57 BLOCKSZ=10260 INCRSZ=01
RELSP RECFORM=FB;
\ASSIGN SIN ACCEPT1 FILESTAT=SYSIN;
\ENDSTEP;
上記ではJCL中で定義されたASSIGN1というSYSINの内容をSINというファイル識別名に割り当てています。これをperlに置き換える(この部分自動的に処理しています)と

INPUT "ACCEPT1,TYPE=DATASSF,LIST=YES",<<_EOT;
4241122 登録データ1
4241123 登録データ1追加分
_EOT
ENDINPUT;

ADAM2200:
STEP "PROG2000 FILE=USL.CAT1 DUMP=DATA SUBLM=NORMAL";
ASSIGN "FILE0010 USR.F001 SHARE=ALL HOLDMODE=NO";
ASSIGN "FILE0110 USR.F011-T FILESTAT=TEMP PUBLIC NORMAL=PASS";
ALLOCATE "FILE0110 USR.F011-T SIZE=05";
DEFINE "FILE0110 RECSIZE=57 BLOCKSZ=10260 INCRSZ=01",
"RELSP RECFORM=FB";
ASSIGN "SIN ACCEPT1 FILESTAT=SYSIN";
上記のように変換しています。さて、SYSINの内容ですがまず1レコードが何byteであるという情報がありません。そして1行毎に行の長さが異なっています。今回移植の対象となった対象機のCOBOLではこのような場合には「改行区切りで1レコード」とするようになっていました。つまり可変長レコードです。ところがOpenCOBOLで可変長レコードをファイルとして扱うためには:
レコード先頭1バイトまたは2バイトにレコード長+1レコード分のデータ
・・・
という形式でデータを作成する必要があります(つまり1byte目がレコード長として正しくないと、メモリ上に過大な長さのデータが読み込まれて、あっという間にSegfault します)。OpenCOBOLの外側からファイルの形式について何らかの方法で指示を出す必要が在りましたので、弊社ではファイル名の先頭に「sysin://」という識別子を(URI的に)付けてファイル名を渡すようにしています。これをOpenCOBOL内のファイルハンドラに渡る前に処理し、改行区切りの可変長レコードとして処理しています。同じく、印刷用の中間データなど1行の長さが可変長となる場合について「sysout://」という識別子を付けて指定することができるようにしています。他、標準の固定長レコードのドライバと動作をちょっと変えたドライバを使いたい場合を考え「misam://」や「mseq://」さらにLinux他では/dev/nullに該当するものとして「nullfs://」という識別子を指定可能としています。
標準の固定長レコードのドライバと動作をちょっと変えたいというのは例えばレコード挿入、削除時の細かい振る舞い、二次キー指定時の動作、二次キーを持っているISAMファイルを主キーしか定義していないCOBOLソースから書き込みモードで開いた場合の動作(OpeCOBOLの標準の動作では、書き込みモードでISAMファイルを開くと、一旦削除されますので、最悪二次キーについての定義が欠落します)等々です。
また、「perlfs://CLASSNAME/param」という形式でファイル名を渡す事によりファイルハンドラとしてperlにて記述したものを呼び出すようにもしています。DBとCOBOL内の固定長レコードの編集用コードについてperlで記述できるため、大変柔軟にDBとの連携を図れるようになりました(つまり、DBD::PgやDBD:MySQL、Oracleなどとの連携も可能です。MySQLについては既に運用されていますし、KeyValue系のDBへの接続もそれほどの変更なしに実装できます)。
上記に加え、固定長レコードやキー定義などの情報を別ディレクトリ内の管理ファイルに登録しておくことで、ファイルオープン時に正しい形式のファイルを使用しているかどうかCOBOLプログラム内の定義と照らし合わせて動的にチェックできるようになり、また現在どのようなファイルがオープン状態であるか?を全てモニタできるようにしています。
これらの改造はOpenCOBOLがオープンソースとして配布されていたことで可能になりました。成果は随時コミュニティ等にフィードバックしていきたいと考えております。

aikawa

正規化しないと駄目かな

PostgreSQL8.1を使ったあるシステムでのお話しです。

まずユーザデータのテーブルが有り、そのユーザはID(連番)で管理されています。
そしてユーザが登録するデータテーブルには、データごとにそのデータを共有するユーザのIDが複数登録されています。
これはユーザIDをCSV形式の文字列で格納をしているんですが、条件文でLIKEとORを連発するのでデータ量が多くなると検索が非常に重くなります。

正規化しないと駄目かなと考えたんですが、対象となるテーブルが複数有るので修正に必要な箇所が散在していて、そのうえデータ量が多くなるテーブルは1つか2つしかないので、構造を変えずにどうにかならないかと別の方法を探しました。

結果として一応、postgresql-contribに含まれるtsearch2が、分かち書き形式の全文検索が出来るので良い感じかなと言う事でやってみました。
日本語には対応していませんが、今回は不要なので構いません。
(GINインデックスは対応が8.2からだったのでパスしました)

postgresql-contribは既にインストールされているので、postgresユーザになって、
psql dbname -f /usr/share/pgsql/contrib/tsearch2.sql

次にpsql dbnameでログインして、GRANTを掛けます。
GRANT ALL ON pg_ts_cfg TO PUBLIC;
GRANT ALL ON pg_ts_cfgmap TO PUBLIC;
GRANT ALL ON pg_ts_dict TO PUBLIC;
GRANT ALL ON pg_ts_parser TO PUBLIC;

とりあえずテスト。
CREATE TABLE test_tb(testts tsvector);
CREATE INDEX test_tb_testts ON test_tb USING gist (testts);

何事もなく作成されたので、データを入れてみて、SELECT。
データ中に2と4の含まれるデータを検索します。
SELECT * FROM test_tb WHERE testts @@ to_tsquery('default', '2&4'); -- and検索
SELECT * FROM test_tb WHERE testts @@ to_tsquery('default', '2|4'); -- or検索

EXPLAINすると、INDEXを使用しているようです。
Bitmap Heap Scan on test_tb (cost=4.10..108.72 rows=27 width=32)
Filter: (testts @@ ”’2” & ”4”’::tsquery)
-> Bitmap Index Scan on test_tb_index (cost=0.00..4.10 rows=27 width=0)
Index Cond: (testts @@ ”’2” & ”4”’::tsquery)

これを応用して、対象となるhogeテーブルのcol列にtsvector型に対応させたインデックスを作成します。
一応カンマからスペースに変更して、格納するようにreplaceしています。
CREATE INDEX hoge_col ON hoge USING gist (to_tsvector('default', replace(col,',',' ')));
SELECT * FROM hoge WHERE to_tsvector('default', replace(col,',',' ')) @@ to_tsquery('default', '2|4');

これで一応インデックスは効いているようです。
今までのクエリはインデックスを使わないでそのまま使えるし、インデックススキャンが必要なところは都度対応する事が出来ます。
とはいえ、かなり強引かなと思える方法なので、今後見て行かないとこれでOKかは分かりませんが・・・。
それと、どちらも許容範囲では有りますが、メモリ上に一度乗るとインデックス使わない検索の方が早い事も有ります。

何か他に良い方法は無いものか。

murave

OS X に導入した PostgreSQL の自動起動を無効にする

PostgreSQL が自動起動するようになっていたので止めときます。開発・検証用ですので。

OS X では daemon の起動は launchctl コマンドで設定できるようです。拡張子が plist な設定ファイルでコントロールしているそうなので探します。

$ locate plist | grep postgres
/Library/LaunchDaemons/com.edb.launchd.postgresql-8.4.plist
/Library/PostgreSQL/8.4/uninstall-postgresql.app/Contents/Info.plist

com.edb.launchd.postgresql-8.4.plist というファイルのようです。

$ sudo launchctl unload -w /Library/LaunchDaemons/com.edb.launchd.postgresql-8.4.plist

再起動して確認。

$ ps ax | grep postgres
419 s000 S+ 0:00.00 grep postgres

おけおけ。

逆に自動起動させたいときは

$ sudo launchctl load -w /Library/LaunchDaemons/com.edb.launchd.postgresql-8.4.plist

ですかね。

murave

NATなFusion上のWindowsからホストのPostgreSQLに接続

MacBookにPostgreSQLを『Mac OS X で PostgreSQL を使ってみよう』(http://lets.postgresql.jp/documents/tutorial/macosx/)を参考にしつつ導入したのですがpsqlで日本語が通らず困ってたりする今日この頃です。ヘルプミー。

とりあえず、VMware Fusiion3上のWindows7にもPostgreSQLを入れたのですが、ServerだけMac側を使おうかなと。サーバーUnix系OS、クライアントWindowsな実環境に近くなりますし。

ってなわけで、Fusion上のWin7がどうなっているやら調べます。ipconfigで見てみましょう。ネットワーク アダプタはNATです。

IPv4 アドレス . . . . . . . . . . : 192.168.249.131

サブネット マスク . . . . . . . . : 255.255.255.0

デフォルト ゲートウェイ . . . . . : 192.168.249.2
ということで、ホストのアドレスは192.168.249.1のようですね。

次、OS X に導入したPostgreSQL8.4がどうなってるのか探ります(ちょい前に導入したもので設定を忘れてまして)。探っていくと、/Library/PostgreSQL/ってなところにインストールされているようです。

設定ファイルを探します。デフォルトだとデータと同じ場所に設定ファイルがありますね。

$ sudo ls -l /Library/PostgreSQL/8.4/data/
total 80
-rw------- 1 postgres daemon 4 1 15 08:41 PG_VERSION
drwx------ 6 postgres daemon 204 1 16 21:07 base
drwx------ 42 postgres daemon 1428 3 18 17:33 global
drwx------ 3 postgres daemon 102 1 15 08:41 pg_clog
-rw------- 1 postgres daemon 3405 1 15 08:41 pg_hba.conf
-rw------- 1 postgres daemon 1631 1 15 08:41 pg_ident.conf
drwxr-xr-x 69 postgres daemon 2346 3 23 00:00 pg_log
drwx------ 4 postgres daemon 136 1 15 08:41 pg_multixact
drwx------ 3 postgres daemon 102 3 23 11:24 pg_stat_tmp
drwx------ 3 postgres daemon 102 1 15 08:41 pg_subtrans
drwx------ 2 postgres daemon 68 1 15 08:41 pg_tblspc
drwx------ 2 postgres daemon 68 1 15 08:41 pg_twophase
drwx------ 4 postgres daemon 136 1 15 08:41 pg_xlog
-rw-r--r-- 1 postgres wheel 16779 1 15 08:42 postgresql.conf
-rw------- 1 postgres daemon 70 3 18 17:33 postmaster.opts
-rw------- 1 postgres daemon 52 3 18 17:33 postmaster.pid

ありました。設定見たり、いじったりしましょう。

まずは postgresql.conf。postgresさんの持ち物らしいので、なりきってGO。

$ sudo -u postgres vim /Library/PostgreSQL/8.4/data/postgresql.conf

で、眺めると、全てのアドレスでlistenはしてるようです。

listen_addresses = '*' # what IP address(es) to listen on;

修正は必要ありませんでした。

次、pg_hba.confを同じくpostgresさんになりきってエディターで開きます。

# TYPE DATABASE USER CIDR-ADDRESS METHOD

# "local" is for Unix domain socket connections only
local all all md5
# IPv4 local connections:
host all all 127.0.0.1/32 md5
# IPv6 local connections:
host all all ::1/128 md5

当然、192.168.249.131からの接続は許可されてません。今回は192.168.249.*からtrust(認証なし)にすることにします。

# TYPE DATABASE USER CIDR-ADDRESS METHOD

# "local" is for Unix domain socket connections only
local all all md5
# IPv4 local connections:
host all all 127.0.0.1/32 md5
# IPv6 local connections:
host all all ::1/128 md5
# Win7 on Fusion3 connections
host all all 192.168.249.0/24 trust

trustな行が追記分です。保存して、PostgreSQLをリスタート。

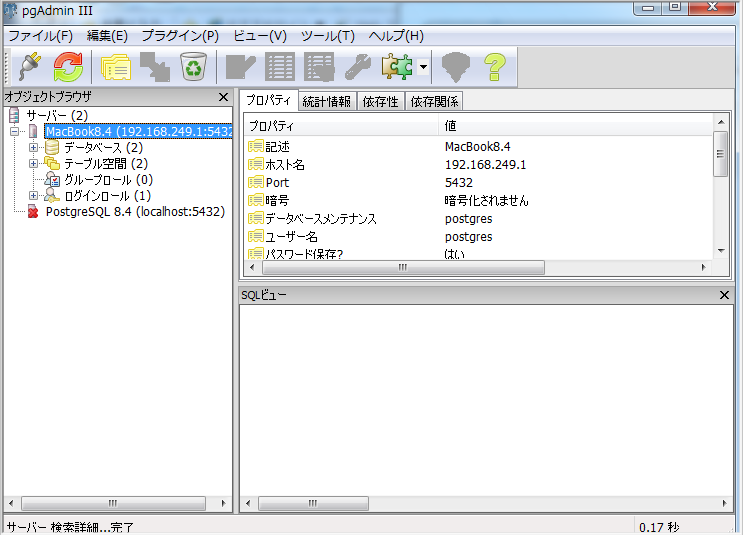
Fusion 上の Win7 で pgAdmin III を起動して接続してみます。

よしよし。

aikawa

PostgreSQL9.0が正式リリースされたようですね

http://www.postgresql.jp/

やはり最大の特徴はレプリケーションやホットスタンバイ等が統合されている点でしょうか。
これでマスタースレーブへの導入が進むとか、新しい使い方も出て来そうな気もしますが、試すには時間が無いかな。

aikawa

複数テーブルをまたいで重複しないIDを自動的に振る(PostgreSQL)


CREATE TABLE test(id serial, hoge text, primary key(id));
CREATE TABLE test2(id int default nextval(pg_get_serial_sequence('test'::text,'id'::text)::regclass), hoge text);

INSERT INTO test(hoge) VALUES('hoge');
INSERT INTO test2(hoge) VALUES('hoge');
INSERT INTO test(hoge) VALUES('hoge');

PostgreSQL8.1.9で確認。

testのidには1,3が、test2のidには2が入ります。
立っているclassは親でも使えと言う感じです。
デフォルト値にはcurrvalも使えますが、setvalで初期値を忘れずに。

普通に使う機会が無さそうなものばかりで。