
kaggleを試してみた
- 2018/06/11
- suganuma
最近機械学習の勉強をはじめました。何冊か本を購入しザーッと目を通し(深くは理解できてません)、次に何か適当なサンプルで機械学習を試してみようと思いましたが、なかなか都合が良いデータというのはないです。
そんな時にKaggleを見つけました。Kaggleはデータ分析コンペを行うサイトですが、機械学習を勉強するのにも、すごく役立つサイトです。
「Titanic: Machine Learning from Disaster」という学習用のコンペをチュートリアルで最初にやるようになってますが、すでに日本語でたくさん紹介されてるので「House Prices: Advanced Regression Techniques」というのをやってみます。タイタニックが分類に対してこれは回帰の問題です。
やってみる、といっても初心者には何からやるのか検討がつきませんが、Kaggleには多くの方々が自分が行ったコード等(Kernels)を説明付きで公開してくれているので、それらを真似すればできます。
最初は人が作ったKernelsをひたすら見て自分のものにする、という感じかと思います。
以下も基本、人が作ったKernelsを参考に書いてます。
また、Kaggleには開発環境もあり、スクリプトまたはノートブック(Jupyter Notebook)の形式でブラウザから試すことできます。システムとしてよくできていると思います。
目的
アイオワ州のエイムズにある住宅価格を79の特徴量より予測します。Ames Housing dataset
データの前処理
ライブラリを読み込みます。
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib
import matplotlib.pyplot as plt
from scipy.stats import skew
from scipy.stats.stats import pearsonr
%config InlineBackend.figure_format = 'retina' #set 'png' here when working on notebook
%matplotlib inline
データを確認してみます。
train = pd.read_csv("../input/train.csv")
test = pd.read_csv("../input/test.csv")
train.head()
IdMSSubClassMSZoningLotFrontageLotAreaStreetAlleyLotShapeLandContourUtilitiesLotConfigLandSlopeNeighborhoodCondition1Condition2BldgTypeHouseStyleOverallQualOverallCondYearBuiltYearRemodAddRoofStyleRoofMatlExterior1stExterior2ndMasVnrTypeMasVnrAreaExterQualExterCondFoundationBsmtQualBsmtCondBsmtExposureBsmtFinType1BsmtFinSF1BsmtFinType2BsmtFinSF2BsmtUnfSFTotalBsmtSFHeating…CentralAirElectrical1stFlrSF2ndFlrSFLowQualFinSFGrLivAreaBsmtFullBathBsmtHalfBathFullBathHalfBathBedroomAbvGrKitchenAbvGrKitchenQualTotRmsAbvGrdFunctionalFireplacesFireplaceQuGarageTypeGarageYrBltGarageFinishGarageCarsGarageAreaGarageQualGarageCondPavedDriveWoodDeckSFOpenPorchSFEnclosedPorch3SsnPorchScreenPorchPoolAreaPoolQCFenceMiscFeatureMiscValMoSoldYrSoldSaleTypeSaleConditionSalePrice0160RL65.08450PaveNaNRegLvlAllPubInsideGtlCollgCrNormNorm1Fam2Story7520032003GableCompShgVinylSdVinylSdBrkFace196.0GdTAPConcGdTANoGLQ706Unf0150856GasA…YSBrkr85685401710102131Gd8Typ0NaNAttchd2003.0RFn2548TATAY0610000NaNNaNNaN022008WDNormal2085001220RL80.09600PaveNaNRegLvlAllPubFR2GtlVeenkerFeedrNorm1Fam1Story6819761976GableCompShgMetalSdMetalSdNone0.0TATACBlockGdTAGdALQ978Unf02841262GasA…YSBrkr1262001262012031TA6Typ1TAAttchd1976.0RFn2460TATAY29800000NaNNaNNaN052007WDNormal1815002360RL68.011250PaveNaNIR1LvlAllPubInsideGtlCollgCrNormNorm1Fam2Story7520012002GableCompShgVinylSdVinylSdBrkFace162.0GdTAPConcGdTAMnGLQ486Unf0434920GasA…YSBrkr92086601786102131Gd6Typ1TAAttchd2001.0RFn2608TATAY0420000NaNNaNNaN092008WDNormal2235003470RL60.09550PaveNaNIR1LvlAllPubCornerGtlCrawforNormNorm1Fam2Story7519151970GableCompShgWd SdngWd ShngNone0.0TATABrkTilTAGdNoALQ216Unf0540756GasA…YSBrkr96175601717101031Gd7Typ1GdDetchd1998.0Unf3642TATAY035272000NaNNaNNaN022006WDAbnorml1400004560RL84.014260PaveNaNIR1LvlAllPubFR2GtlNoRidgeNormNorm1Fam2Story8520002000GableCompShgVinylSdVinylSdBrkFace350.0GdTAPConcGdTAAvGLQ655Unf04901145GasA…YSBrkr1145105302198102141Gd9Typ1TAAttchd2000.0RFn3836TATAY192840000NaNNaNNaN0122008WDNormal250000
データの変換
ほとんどのモデルは特徴量及び出力がガウス分布に従っている方がうまくいきます。ヒストグラムが左右対称の「ベルカーブ」になるように、特徴量及び出力にlogを適用します。
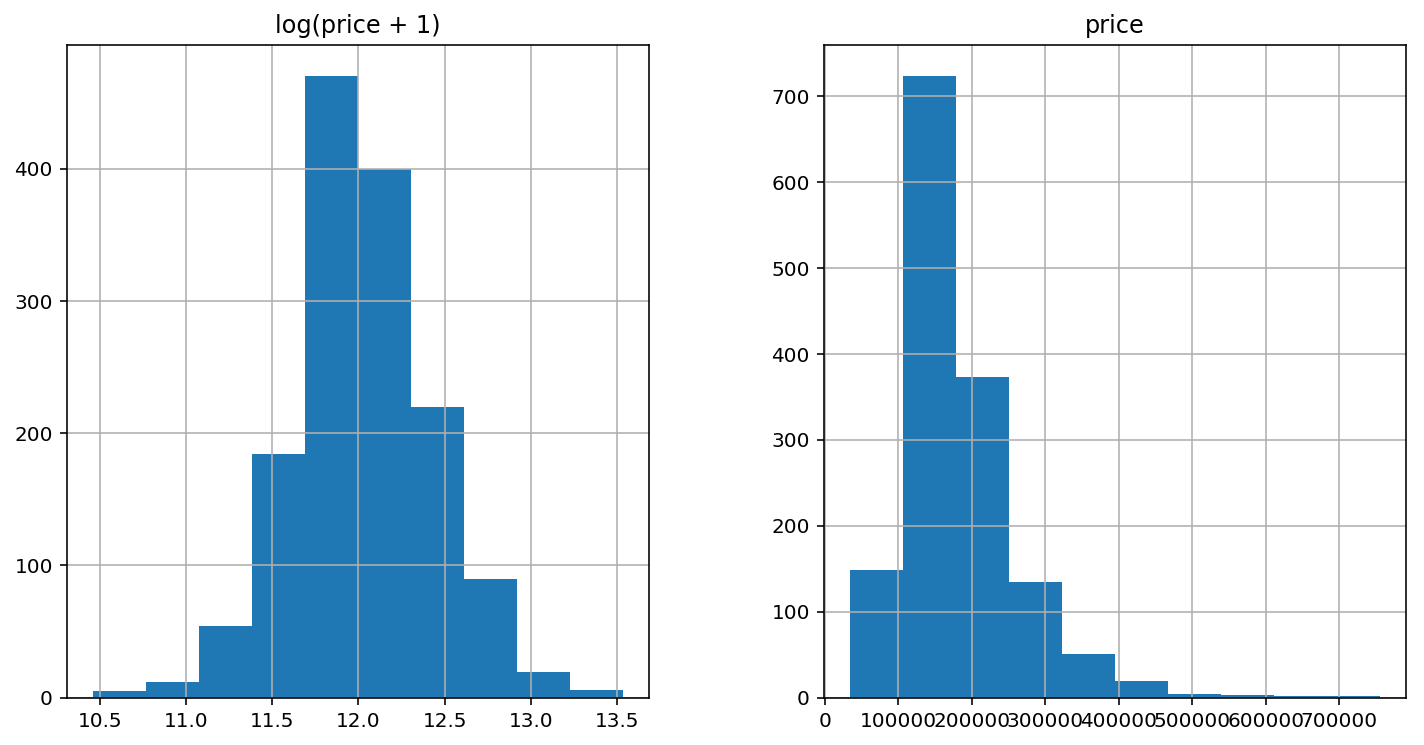
matplotlib.rcParams['figure.figsize'] = (12.0, 6.0)
prices = pd.DataFrame({"price":train["SalePrice"], "log(price + 1)":np.log1p(train["SalePrice"])})
prices.hist()
出力「SalePrice」はlog(price + 1)で、歪度がだいぶ減りました。1を足してるのは、データに値 0 があるので(そして対数 は0に対して定義できないので)、直接logを使うことはできないためです。
train["SalePrice"] = np.log1p(train["SalePrice"])
特徴量で、数値でかつ歪度が大きい場合のみ同様の変換を行います。
all_data = pd.concat((train.loc[:,'MSSubClass':'SaleCondition'],
test.loc[:,'MSSubClass':'SaleCondition']))
# 数値のみ
numeric_feats = all_data.dtypes[all_data.dtypes != "object"].index
# 欠損値NaNを除外後、歪度を計算
skewed_feats = train[numeric_feats].apply(lambda x: skew(x.dropna()))
skewed_feats = skewed_feats[skewed_feats > 0.75]
skewed_feats = skewed_feats.index
all_data[skewed_feats] = np.log1p(all_data[skewed_feats])
カテゴリ変数の変換特徴量がカテゴリ文字列のデータを、回帰で扱えるようするため数値に変換します。ワンホットエンコー ディングという方法を使い、カテゴリ変数を1つ以上の0と1の値を持つ新しい特徴量で置き換えます。
たとえばGarageQualという特徴量は、Ex(Excellent)、Gd(Good)、TA(Typical/Average)、Fa(Fair)、Po(Poor)、NA(No Garage)のいづれかの値を持ちますが、新たに以下の0または1の値を持つ特徴量を作ります。
GarageQual_Ex、GarageQual_Gd、GarageQual_TA、GarageQual_Fa、GarageQual_Po、GarageQual_NA。
というのを以下の一行でやってくれます。
all_data = pd.get_dummies(all_data)
欠損値を平均値で埋めるall_data = all_data.fillna(all_data.mean())
モデル作成特徴量の中にはあまり重要でないものがあるようなので、L1正則化を行うLasso回帰でモデルを作ります。L1正則化を行うと、いくつかの係数は無視されます。
X_train = all_data[:train.shape[0]]
X_test = all_data[train.shape[0]:]
y = train.SalePrice
from sklearn.linear_model import Lasso
model_lasso = Lasso()
scores = cross_val_score(model_lasso, X_train, y) # 交差検証で評価
scores.mean()
0.54583131173476207デフォルトだとスコア低いです。Lassoのパラメータalphaをいろいろ変えて最適な値を見つけます。
というのを、交差検証を用いて最適なalphaを探してくれるLassoCVがやってくれます。
from sklearn.linear_model import LassoCV
model_lasso = LassoCV(alphas = [1, 0.1, 0.001, 0.0005]).fit(X_train, y)
scores = cross_val_score(model_lasso, X_train, y) # 交差検証で評価
scores.mean()
0.90117979437604168どの特徴量が影響を及ぼしているか確認してみます。
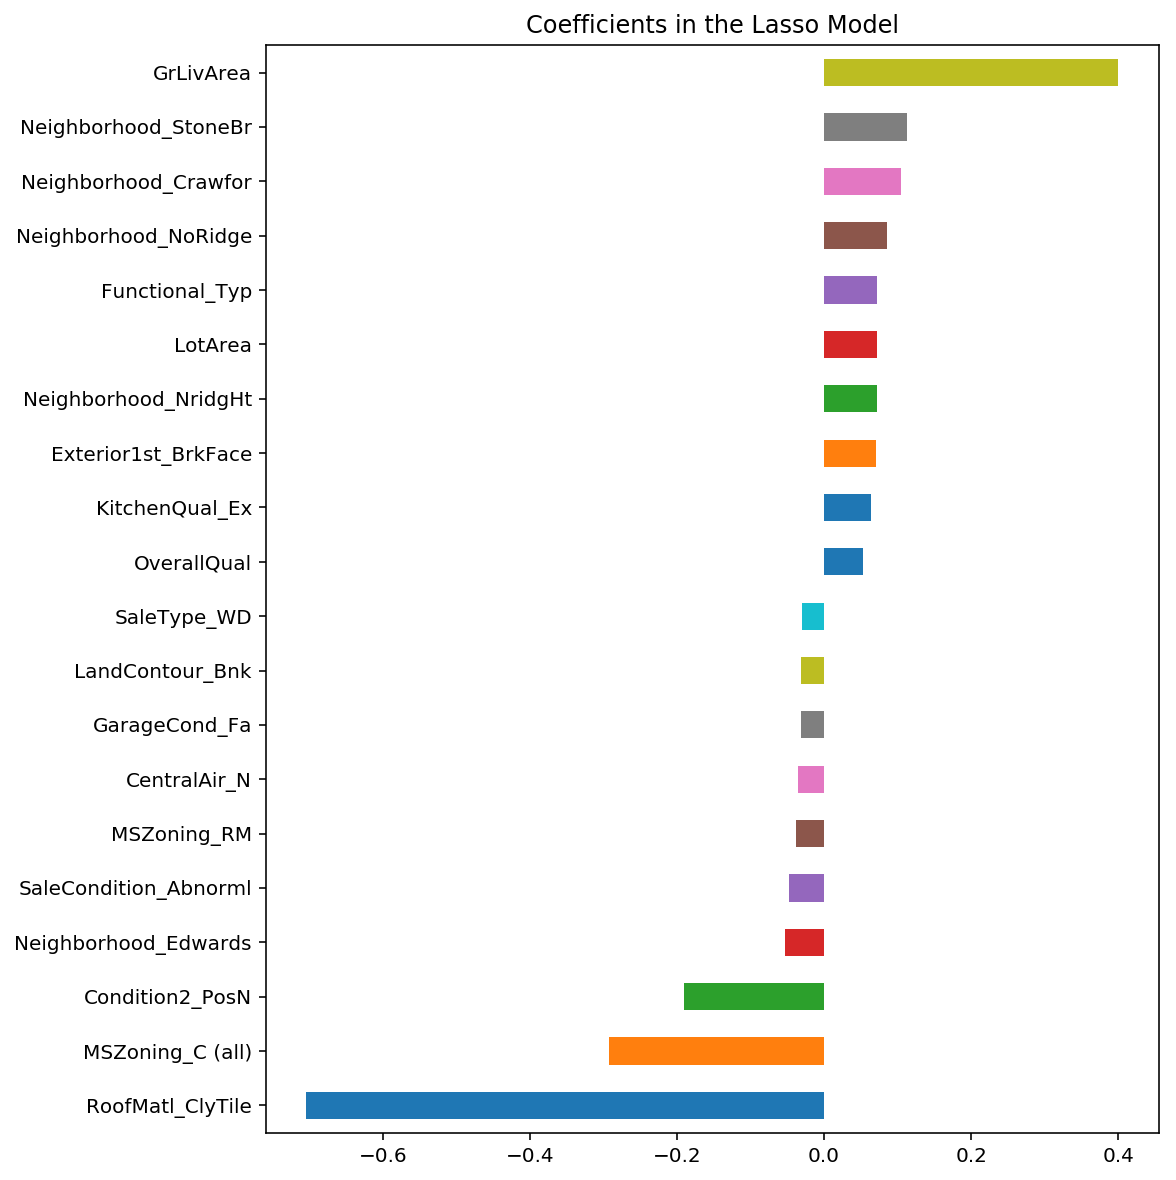
coef = pd.Series(model_lasso.coef_, index = X_train.columns)
imp_coef = pd.concat([coef.sort_values().head(10),
coef.sort_values().tail(10)])
matplotlib.rcParams['figure.figsize'] = (8.0, 10.0)
imp_coef.plot(kind = "barh")
plt.title("Coefficients in the Lasso Model")
GrLivAreaとは、地上の建物面積です。
Above grade (ground) living area square feet
テストデータを予測
テストデータを予測し、expを適用し元に戻します。
y_test_pred = model_lasso.predict(X_test)
y_test_pred = np.exp(y_test_pred)-1
提出ファイル「submission.csv」を作成submission = pd.DataFrame({"Id": test["Id"],"SalePrice": y_test_pred})
submission.loc[submission['SalePrice'] <= 0, 'SalePrice'] = 0
fileName = "submission.csv"
submission.to_csv(fileName, index=False)
あとは、outputタブを開き、「Submit to Competition」ボタンを押すと、ファイルがサブミットされ、Score計算が行われ、結果がLeader board上で表示されます。